Le Cache de Prompts : Comment Réduire de 80% les Coûts de vos Agents IA en Entreprise
Vos agents IA relisent intégralement leur contexte à chaque étape. C'est comme demander à un consultant de relire l'intégralité d'un dossier de 500 pages avant chaque réunion — même si 90% du contenu n'a pas changé. Cette inefficacité, longtemps acceptée comme une fatalité technique, a désormais une solution concrète : le prompt caching, désormais disponible pour les modèles OpenAI déployés sur Amazon Bedrock. Pour les entreprises françaises qui industrialisent leurs usages IA, c'est un tournant économique et opérationnel majeur.
Le Problème du "Jour de la Marmotte" dans vos Workflows IA
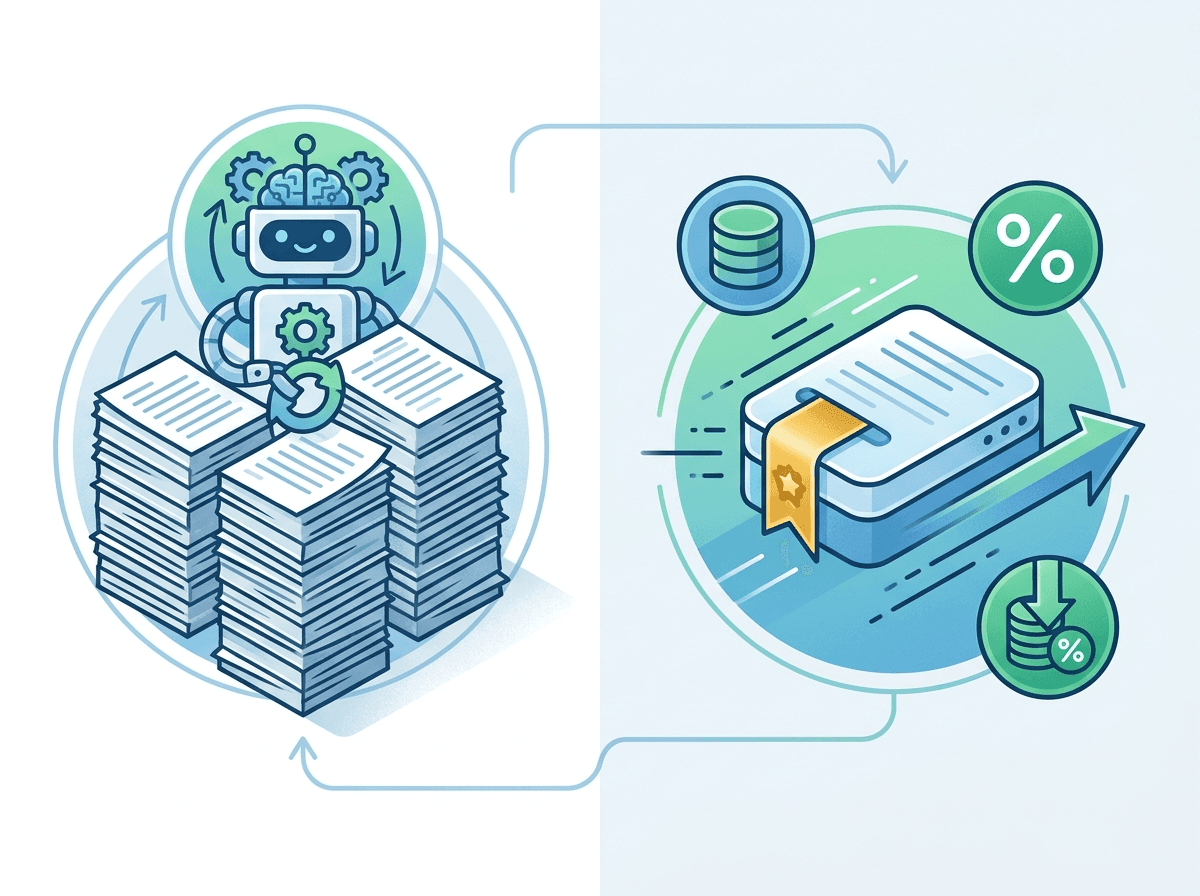
Imaginez un agent IA chargé de traiter les demandes clients de votre service après-vente. À chaque interaction, cet agent doit recevoir et retraiter l'intégralité de son contexte : ses instructions système, la liste de ses outils disponibles, l'historique de la conversation, les politiques internes, les fiches produits pertinentes. Tour après tour, étape après étape, il "relit" tout depuis le début — comme le personnage de Bill Murray dans Un Jour Sans Fin, condamné à revivre la même journée indéfiniment.
Ce comportement n'est pas anecdotique. Dans un agent conversationnel métier typique, le contexte fixe (instructions, outils, base de connaissances) peut représenter 70 à 90% des tokens envoyés à chaque appel. Cela se traduit par :
- Des coûts d'inférence qui s'envolent à mesure que les conversations s'allongent
- Une latence accrue pénalisant l'expérience utilisateur
- Un gaspillage computationnel incompatible avec une démarche IA responsable
La bonne nouvelle : Amazon Bedrock introduit le prompt caching pour les modèles OpenAI (GPT-4o et ses variantes), permettant de mémoriser les portions stables du contexte entre les appels successifs. Le modèle n'a plus besoin de retraiter ce qu'il connaît déjà.
Comment Fonctionne le Prompt Caching et Pourquoi C'est un Levier Stratégique
Le principe est élégant dans sa simplicité : vous identifiez les portions invariantes de votre prompt (instructions système, définitions d'outils, documents de référence) et vous les marquez comme candidates au cache. Amazon Bedrock stocke alors le résultat du traitement de ces segments. Lors des appels suivants, si ces portions sont identiques, le système réutilise les résultats mis en cache plutôt que de tout recalculer.
Concrètement, les gains observés sont significatifs :
- Réduction des coûts d'entrée jusqu'à 80% sur les tokens mis en cache
- Diminution de la latence de 30 à 50% sur les appels successifs
- Scalabilité améliorée pour les déploiements à fort volume
Pour une entreprise française déployant un agent IA de support interne traité 10 000 fois par jour avec un contexte de 8 000 tokens, l'économie mensuelle peut rapidement atteindre plusieurs milliers d'euros — sans aucun compromis sur la qualité des réponses.
Du point de vue de l'architecture, la stratégie consiste à structurer vos prompts en couches : d'abord les éléments les plus stables (cachés en priorité), puis les éléments semi-dynamiques (historique récent), enfin la requête courante de l'utilisateur. Cette discipline de conception devient un véritable levier de compétitivité pour les équipes techniques.
Applications Concrètes pour les Entreprises Françaises
Cette avancée technique prend tout son sens lorsqu'on l'applique aux cas d'usage les plus courants dans les organisations françaises :
Service client et support technique : Un agent qui maîtrise les CGV, la documentation produit et les procédures internes n'a plus besoin de les recharger à chaque échange. Le cache mémorise ce socle réglementaire et produit — particulièrement pertinent dans les secteurs régulés comme la banque, l'assurance ou la santé où les référentiels sont volumineux mais stables.
Assistants juridiques et conformité : Les cabinets d'avocats et directions juridiques déployant des agents d'analyse documentaire peuvent cacher l'intégralité de leur corpus réglementaire (RGPD, droit du travail, réglementations sectorielles). Seul le document soumis à analyse change — le reste est mis en mémoire.
Agents de génération de contenu : Les équipes marketing utilisant des agents IA pour produire des contenus cohérents avec leur charte éditoriale peuvent cacher cette charte, le glossaire de la marque et les exemples de référence. Chaque nouvelle demande de contenu bénéficie ainsi d'un contexte de marque instantanément disponible.
ERP et systèmes métier : Les agents connectés à des ERP (SAP, Sage, etc.) qui doivent connaître la structure des données, les règles métier et les APIs disponibles peuvent cacher cette couche de connaissance applicative, ne transmettant que les données transactionnelles réellement nouvelles.
Dans tous ces cas, le pattern est identique : séparer ce qui est stable de ce qui est dynamique, et confier au cache la responsabilité de la mémoire structurelle de l'agent.
Former vos Équipes à une Nouvelle Discipline de Conception IA
L'introduction du prompt caching ne se résume pas à un paramètre technique à activer. Elle implique une évolution des compétences au sein des équipes qui conçoivent et maintiennent les agents IA en entreprise.
Les développeurs et prompt engineers doivent désormais intégrer une nouvelle dimension dans leur pratique : penser en termes de stabilité relative des informations. Quelles parties du prompt changent à chaque appel ? Lesquelles restent fixes pendant une session ? Lesquelles sont permanentes ? Cette cartographie devient un exercice de conception à part entière.
Les architectes solutions doivent quant à eux repenser les pipelines d'agents pour maximiser la réutilisation du cache — ce qui peut impliquer de revoir l'ordre des éléments dans les prompts, de normaliser les instructions système ou de créer des bibliothèques de prompts partiels réutilisables.
Enfin, les product managers et décideurs métier ont besoin de comprendre l'impact économique de ces choix de conception pour arbitrer les investissements : un agent mal conçu du point de vue du caching peut coûter trois à cinq fois plus cher qu'un agent optimisé, pour des résultats identiques.
Chez Ikasia, nous accompagnons les entreprises françaises dans cette montée en compétences, de la sensibilisation des équipes dirigeantes à la formation technique des développeurs, en passant par l'audit des architectures IA existantes. La maîtrise du coût total de possession (TCO) de vos agents IA commence par une formation adaptée aux réalités de vos systèmes.
Le prompt caching n'est pas une optimisation marginale réservée aux géants du numérique. C'est une pratique d'ingénierie IA mature, désormais accessible aux entreprises de toutes tailles via Amazon Bedrock, qui conditionne directement la rentabilité et la scalabilité de vos projets d'agents autonomes.
Vous déployez ou envisagez de déployer des agents IA dans votre organisation ? Découvrez comment Ikasia peut vous aider à concevoir des architectures performantes et économiquement viables. Visitez ikasia.ai pour explorer nos formations et prestations de conseil en IA appliquée à l'entreprise.
Tags
Formations associées
Articles similaires
OpenAI sur Amazon Bedrock : ce que la disponibilité en Asie-Pacifique change pour les entreprises françaises à l'international
Lire
100 millions d'appels par mois grâce à l'IA vocale : ce que la révolution Retell AI signifie pour les entreprises françaises
Lire
Decisions API d'OpenAI : Comment accélérer vos prises de décision métier grâce à l'IA à faible coût
LireEnvie d'aller plus loin ?
Ikasia propose des formations IA conçues pour les professionnels. De la stratégie aux ateliers techniques pratiques.